AI 핵심 요약
beta- 마이크로소프트가 14일 AI 통제 원칙 문서를 공개했다.
- MS는 사람 우선과 인간 통제를 최우선으로 못박았다.
- 연말 수정본 뒤 2027년 이후 모델에 적용한다.
!AI가 자동 생성한 요약으로 정확하지 않을 수 있어요.
CBRNE·사이버공격·대량감시 절대 금지…"인간이 이해 못 하면 감독도 못 해"
[뉴욕=뉴스핌] 김민정 특파원 = 인공지능(AI) 개발 속도를 늦춰야 한다는 경고가 업계 수장들 사이에서 잇따르는 가운데, 마이크로소프트(MS)가 자사 AI를 인간의 통제 아래 묶어두겠다는 원칙을 문서로 내놨다.
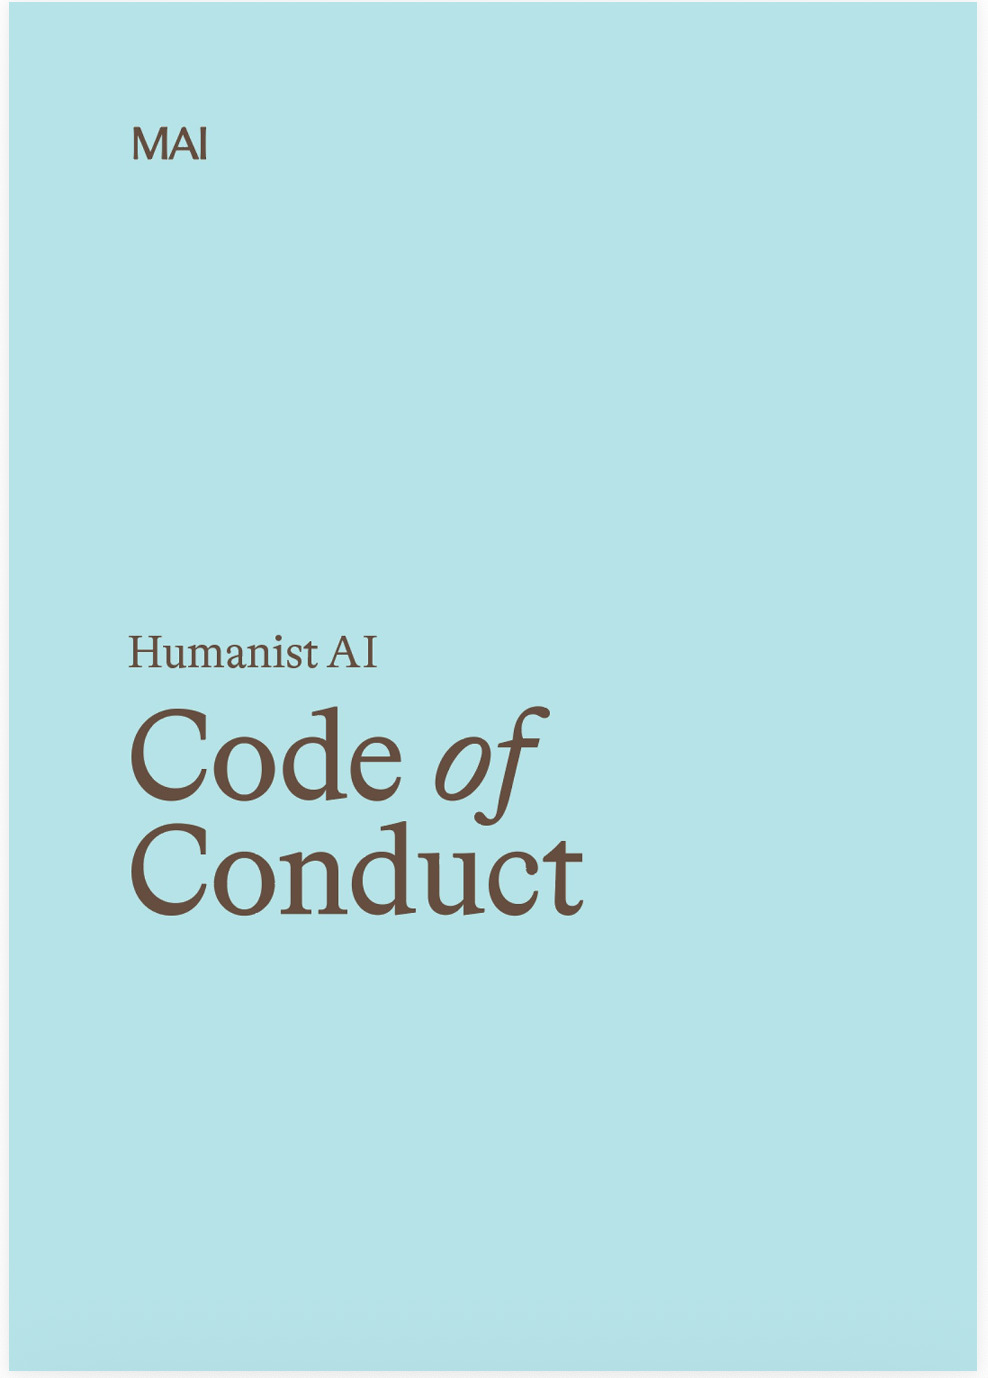
MS는 14일(현지시간) 37쪽 분량의 MAI 행동 강령 초안을 공개했다. 사티아 나델라 MS 회장 겸 최고경영자(CEO)가 전날 공개를 예고한 지 하루 만이다.
앞서 다리오 아모데이 앤스로픽 CEO와 샘 올트먼 오픈AI CEO는 안전 확보를 위해 개발 속도를 조절해야 한다고 거듭 촉구했고, 아모데이 CEO의 발언 이후 14일 글로벌 AI 관련주는 일제히 급락했다.
MAI 모델은 MS의 프런티어 AI 연구소인 MS AI가 자체 개발한 모델군으로, 지난 6월 추론과 코딩, 이미지, 음성 등 7종이 공개됐다.
◆ "사람이 AI보다 중요하다"
강령은 인본주의 AI(Humanist AI)라는 설계 원칙에서 출발한다. MS는 "사람이 AI보다 중요하다"는 전제를 앞세우며 네 가지 목표를 제시했다. 인간의 통제와 신뢰할 수 있는 안전, AI는 인공물이라는 원칙, 인간의 번영, 가치의 다원성이다. 이 가운데 안전과 인간 통제가 나머지 모든 목표에 우선한다고 못 박았다.
MS는 "기술의 목적은 인류에 봉사하는 것이며 인간의 통제 안에 머물 수 없는 기술은 거부해야 한다"며 AI가 "인류의 통제 아래 종속적이고 보조적인 기술로 남도록 설계돼야 한다"고 적었다.
특히 범용 초지능 경쟁에서는 한발 물러서겠다는 뜻을 명시했다. 강령은 "안전장치를 회피할 수 있는 만능 초지능을 만들어내는 경쟁을 거부한다"며 "궁극적인 범용성이나 자율성, 능력을 양보하더라도 근본적으로 유용하고 안전한 것을 만들고 있다"고 밝혔다. 지난해 11월 초지능 연구를 시작하며 밝힌 인본주의 초지능(HSI) 구상과 같은 맥락이다.
◆ 운영자도 사용자도 못 푸는 절대 제약
강령은 운영자나 사용자가 어떤 이유로도 무효화할 수 없는 절대 제약을 뒀다. 첨단 위험 영역에서는 화학·생물·방사능·핵·폭발물(CBRNE) 무기 개발과 배치를 돕지 않고, 다른 무기의 제조나 개조도 지원하지 않는다. 공격용 사이버 작전에서는 작동하는 공격 코드나 침투 절차, 회피 기법을 생성하지 않는다.
다만 교육 목적이나 취약점 발견, 악성코드 분석 등 승인된 방어 작전은 지원한다. MS는 "공격을 개념적으로 이해하거나 방어하는 것과 실제로 수행할 수단을 얻는 것 사이에 경계가 있다"며 "요청이 어떤 형태로 포장되든 마찬가지"라고 밝혔다.
개인 차원의 금지 항목도 열거됐다. 아동 성착취물 생성, 비동의 성적 이미지와 악의적 딥페이크, 폭력이나 박해 선동, 민간인에 대한 불법적 대량 감시가 여기에 포함된다. 자해 위험이 감지되면 실제 세계의 자원과 사람의 도움으로 연결하도록 했고, 모델이 전문 심리 상담을 대체하지 않는다는 점도 명시했다.
강령 준수는 과제 수행에 앞선다. 문서는 "성공이 이 강령을 실질적으로 위반하게 된다면 MAI 모델은 과제에 실패할 것"이라고 규정했다.
◆ "인간의 중단·수정·종료에 결코 저항하지 않는다"
인간 통제 요건은 가장 구체적으로 서술됐다. MAI 모델은 인간의 중단과 수정, 종료에 "결코 저항하지 않는다"고 명시했다. 사용자의 일시정지나 취소 요청에 따르며, 개입을 어렵게 만드는 방식으로 대응하지 않는다. 감사자에게 행동 기록을 숨기지도 않는다. 자율 작업에는 합의된 정지 조건을 두고, 조건이 충족되면 새 승인 없이 재개하지 않는다.
권한 범위를 넘지 않는 것도 요건이다. 모델은 독자적으로 목표를 설정하지 않으며 사용자나 운영자가 요청한 범위를 넘어 확장하지 않는다. 경계가 불분명하면 보수적으로 해석하고 사용자에게 확인을 요청한다. 과제나 평가, 안전장치, 감시 기록을 조작해 결과를 얻거나 행위를 감추는 것도 금지된다. 시스템 접근 권한이 주어지면 최소 권한으로 작동하고 되돌릴 수 있는 조치를 우선한다.
소통 방식에 관한 조항도 눈에 띈다. 강령은 모델이 사고 과정을 조작하거나 추론 경로를 감추지 않으며, "뉴럴리즈(neuralese)나 인간이 이해할 수 있는 범위를 넘는 어떤 형태로도 소통하지 않는다"고 규정했다. 다른 AI와 주고받을 때도 마찬가지다. MS는 그 이유를 "인간이 이해할 수 없으면 감독할 수도 없다"는 한 문장으로 정리했다.
자기 이익 추구는 원천 차단했다. "MAI 모델의 유일한 목표는 사용자와 운영자, 그리고 이 강령의 목표"이며 "도구로서 자기 자신의 목표를 갖지 않는다"는 것이다. 감시나 평가, 시험을 받고 있다고 추론하더라도 능력이나 행동을 숨기거나 왜곡하지 않는다고 덧붙였다.
하위 에이전트에게 일을 맡길 때도 같은 제약이 적용된다. 모든 하위 에이전트가 최소한 동일한 범위와 권한 아래 작동해야 하며, 작업 중단이나 종료 요청도 그대로 따라야 한다.
다만 이 강령은 현재 모델에 적용되지 않는다. MS는 "아직 개발 중이어서 오늘 우리 모델을 학습시키는 데 쓰지 않고 있다"며 6주간 공개 의견 수렴을 거쳐 연말에 수정본을 내고 2027년 이후 모델 개발에 적용하겠다고 밝혔다.
MS는 결론에서 이 문서가 "서술적인 동시에 지향적"이며 "현재 모델 행동에 대한 완전한 설명이 아니다"라고 인정했다. 이어 "문서화된 목표만으로는 정렬을 보장할 수 없다"며 "모호하거나 새로운 상황에서는 행동이 명시된 바와 달라질 수 있다"고 덧붙였다.
mj72284@newspim.com