AI 핵심 요약
beta- 중과서광이 14일 스케일패브릭 토큰 가속 기술체계를 발표했다
- 네트워크·연산·스토리지 협업으로 AI 대기시간을 줄였다
- IBGDA는 10만 장급 검증을 마치고 성능 20~30% 향상을 노렸다
!AI가 자동 생성한 요약으로 정확하지 않을 수 있어요.
이 기사는 9월 14일 오전 07시24분 '해외 주식 투자의 도우미' GAM(Global Asset Management)에 출고된 프리미엄 기사입니다. GAM에서 회원 가입을 하면 9000여 해외 종목의 프리미엄 기사를 보실 수 있습니다.
이 기사는 인공지능(AI) 번역을 바탕으로 전문 기자들의 검증과 분석을 거쳐 생산된 콘텐츠로, 원문은 중국 관영 증권시보(證券時報) 9월 11일자 기사입니다.
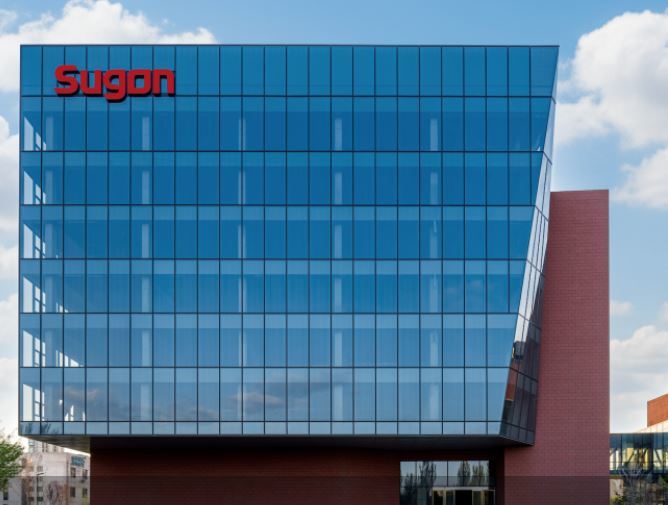
[서울=뉴스핌] 배상희 기자 = AI 인프라 업계의 대표기업 중과서광(中科曙光∙SUGON 603019.SH)이 '스케일패브릭(scaleFabric) 토큰(Token) 가속 기술 체계'를 발표했다.
스케일패브릭은 중과서광이 자체 개발한 AI·고성능컴퓨팅용 네트워크 기술·제품 체계다.
해당 기술 체계는 스케일패브릭의 네이티브 무손실 RDMA(원격 직접 메모리 액세스) 고속 네트워크를 핵심으로 하며, 연산·스토리지·네트워크 간 협업을 통해 데이터 전송 및 읽기 과정에서 발생하는 대기 시간을 줄이고 대형 모델의 실행 효율을 높이는 데 초점을 맞췄다.
이 가운데 GPU가 직접 네트워크 통신을 시작할 수 있도록 지원하는 IBGDA 기술은 10만 장급 클러스터에서 검증을 완료했으며, 중국에서 처음으로 대규모 적용에 성공했다.
Token(토큰)은 대형 모델이 콘텐츠를 처리하고 출력하는 기본 단위로, 생성 효율은 모델의 응답 속도와 서비스 역량에 직접적인 영향을 미친다.
이러한 영향은 학습과 추론 단계에서 특히 두드러진다. 학습 단계에서는 모든 연산 카드가 그래디언트 데이터를 동기화해야 하는 전형적인 동기화 작업이 이뤄진다. 한 장의 카드라도 속도가 느려지면 다른 모든 카드가 대기해야 하며, 비정상적인 지연이 발생할 경우 모델의 연산 활용률(MFU)이 낮아진다.
추론 단계는 입력 전처리와 토큰을 순차적으로 생성하는 두 단계로 나뉜다. 이 과정에서는 대량의 캐시 데이터가 발생해 노드 간 이동이 필요하다. 사용자가 체감하는 '첫 글자 대기시간'과 '입력 생성 속도' 역시 본질적으로 데이터 전송 속도와 밀접한 관련이 있다.
이와 함께 '저장으로 연산을 대체하는 방식'이 업계의 중요한 최적화 방향으로 부상하고 있다. 이미 생성된 중간 캐시 데이터를 저장해 재사용함으로써 연산 자원을 절약하는 방식이다. 이에 따라 스토리지 역시 데이터 이동 과정에 포함되면서 연산·네트워크·스토리지 간 협업 효율이 전체 AI 시스템의 성능 상한선을 결정하기 시작했다.
연구 결과에 따르면 대규모 분산 학습에서 네트워크 통신에 소요되는 시간이 전체의 30~50%에 달하며, 네트워크 성능이 연산 시스템 전체의 효율성에 직접적인 영향을 미친다. 특히 MoE(혼합 전문가) 아키텍처가 확산되면서 모델 실행 과정에서 빈번하고 동시에 발생하는 소규모 메시지 통신이 대량으로 발생하고 있다. 이 과정에서 기존 네트워크 경로의 CPU 오버헤드가 더욱 커지면서 새로운 성능 병목으로 작용하고 있다.
이러한 측면에서 AI 산업의 경쟁은 단일 카드의 연산 성능을 겨루는 단계에서 전체 데이터 전송 과정의 효율성을 높이는 단계로 넘어가고 있다는 분석이다.
또한 중국산 연산 카드 역시 공정 미세화와 첨단 패키징 등의 측면에서 해외 최고 수준 제품과 여전히 격차가 있다. 단일 카드 성능을 따라잡는 데는 장기간의 기술 축적이 필요하다. 하지만 이것이 전체적인 연산 능력의 열세를 의미하는 것은 아니다. 시스템 차원의 혁신을 통해 클러스터 전체의 효율성을 높이는 것이 중국 AI 인프라 산업의 중요한 돌파구로 부상하고 있다.
이러한 접근법은 구체적인 기술 적용으로 이어지고 있다. 이번에 발표한 스케일패브릭 토큰 가속 기술 체계에 적용된 IBGDA(InfiniBand GPUDirect Async) 기술은 GPU 커널이 네트워크 카드를 직접 제어해 통신을 시작하도록 한다. 기존 경로에서 CPU가 명령을 중계하는 과정을 우회해 소규모 메시지 통신의 지연시간을 크게 낮추는 방식이다.
이 같은 기술은 대규모 병렬 소규모 메시지 통신이 빈번하게 발생하는 MoE 모델의 통신 환경에 적합하다. 데이터 전송에 '녹색 통로'를 마련하는 것과 같은 효과가 있다는 설명이다. 중과서광에 따르면 여러 시나리오에서 테스트한 결과 전체 데이터 전송 과정에 대한 최적화를 결합할 경우 시스템 전체 성능을 20~30% 높일 수 있다.
연산 측면의 통신 최적화와 함께 스토리지 측면의 협업 역시 중요하다. 모델 로딩, 캐시 읽기·쓰기, 체크포인트 저장 등 다양한 상황에 맞춰 업계에서는 다층적인 스토리지 가속 솔루션을 구축하고 있다. 이를 통해 연산 장치가 원격 스토리지에 보다 직접적으로 접근할 수 있도록 하고 중간 데이터 이동 과정을 줄이는 방식이다. 이러한 기술들이 함께 연산·스토리지·네트워크 협업을 위한 기술 기반을 구성한다.
중과서광은 스케일패브릭을 기반으로 자체 개발한 IBGDA 기술의 10만 장급 클러스터 검증을 완료했다.
pxx17@newspim.com