纽斯频通讯社首尔10月20日电 韩国三星电子开发一项旨在提高人工智能(AI)服务器内存利用效率的技术,通过优化图形处理器(GPU)与中央处理器(CPU)之间的数据传输和内存调度,使服务器在不增加GPU的情况下,有望处理更多用户请求。

据美国专利信息网站Justia消息,三星电子申请的"大规模语言模型(LLM)的多用户请求处理方法及服务器"专利于15日公开。该技术通过计算不同用户请求的数据传输成本、内存使用量、等待时间以及后续内存需求等因素,调整请求处理顺序,以提高AI服务器的推理效率。
生成式AI在回答用户问题时需要使用GPU进行计算,但GPU可用于临时存储数据的内存容量有限。当多个用户同时发出请求、导致GPU内存不足时,部分数据需要转移至CPU内存,并在后续处理过程中重新调取。这一过程可能增加数据传输耗时,导致AI服务响应延迟。
针对这一问题,三星电子设计了相应算法,旨在减少不必要的数据移动。如果此前已转移至CPU内存的数据仍然存在,系统可以避免重复复制,仅传输所需部分。此外,系统能够在为一名用户生成回答的同时,执行其他用户的数据传输任务。
该技术还可利用剩余内存处理部分计算任务。例如,当处理一项新请求需要5个内存空间单位、但当前仅剩3个单位时,系统可以先利用现有空间处理能够完成的部分,而不必等待全部所需内存腾出。
三星电子表示,该技术并非面向某一特定产品的功能,而是用于提高AI数据中心和云服务器推理效率的基础设施技术,适用于向多个用户提供大语言模型服务的服务器。
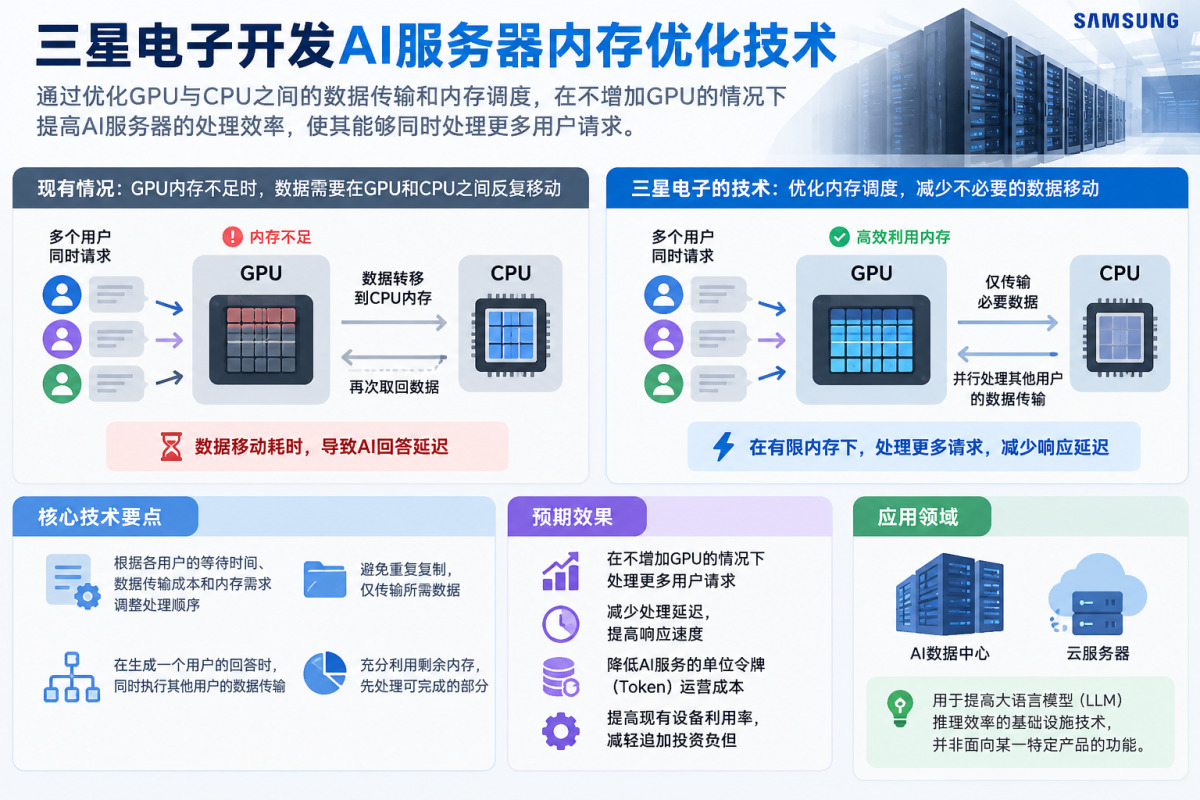
随着AI应用不断普及,数据中心不仅面临GPU采购成本压力,也需要提高现有计算设备的利用效率。三星电子此次开发的技术有望在不增加GPU设备的情况下提高服务器请求处理能力,减少响应延迟,并降低AI服务的单位令牌(Token)运营成本,从而减轻追加基础设施投资的压力。
对于运营大规模GPU基础设施的云服务商而言,提高现有设备的利用率也有望降低扩容成本。不过,该技术在实际商业服务中的应用情况,以及对响应速度和处理量的具体改善幅度,目前尚未得到验证。
业界表示,提高GPU内存利用率有望改善AI服务器的处理效率、降低运营成本,但仍需验证该技术与现有技术相比能够在响应速度和处理量方面实现多大改善,才能进一步判断其经济效益。(完)
韩国纽斯频(NEWSPIM·뉴스핌)通讯社